Il problema di un chatbot "nudo"
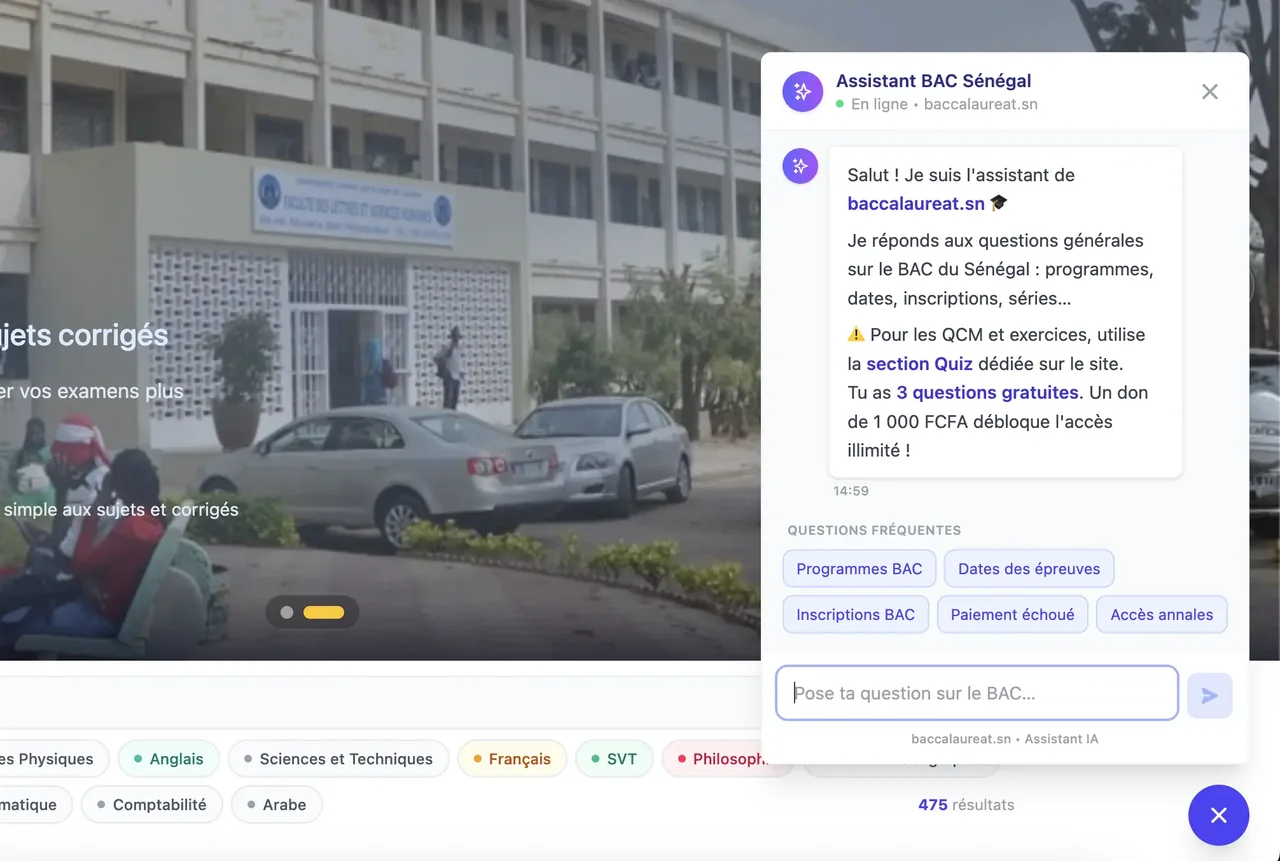
Collegare direttamente un LLM significa rischiare risposte generiche o false (allucinazioni). Su baccalaureat.sn, l'assistente deve rispondere a partire dai MIEI contenuti: prove degli anni precedenti, correzioni, schede per materia e serie. La soluzione: il RAG (Retrieval-Augmented Generation) — si recuperano i passaggi pertinenti dal database, poi si chiede al LLM di rispondere basandosi su di essi.
Il principio in tre fasi
Question élève
   │
   ▼
1. RETRIEVAL : chercher les passages pertinents (annales, fiches)
   │
   ▼
2. AUGMENT : injecter ces passages dans le prompt comme contexte
   │
   ▼
3. GENERATION : le LLM répond EN S'APPUYANT sur le contexte fourni
Retrieval: iniziare semplicemente con MySQL
Non serve un database vettoriale pesante per iniziare. Un primo RAG efficace può basarsi sulla ricerca full-text MySQL, già in uso.
final class AnnalesRetriever
{
    public function __construct(private Connection $connection) {}

    public function search(string $query, int $limit = 4): array
    {
        $sql = <<connection->executeQuery($sql, [
            'q' => $query, 'limit' => $limit,
        ], ['limit' => \PDO::PARAM_INT])->fetchAllAssociative();
    }
}
Il contenuto è suddiviso in chunk (frammenti) indicizzati in full-text. Si recuperano i 4 più pertinenti per la domanda.
Augment: costruire il prompt
public function buildPrompt(string $question, array $chunks): array
{
    $context = '';
    foreach ($chunks as $c) {
        $context .= sprintf(
            "[%s - %s - %s]\n%s\n\n",
            $c['matiere'], $c['serie'], $c['annee'], $c['contenu']
        );
    }

    $system = << 'system', 'content' => $system],
        ['role' => 'system', 'content' => "CONTEXTE:\n{$context}"],
        ['role' => 'user', 'content' => $question],
    ];
}
L'istruzione "rispondi UNICAMENTE a partire dal contesto" è la chiave anti-allucinazione: il LLM è vincolato a non inventare.
Verso gli embeddings quando si cresce
Il full-text MySQL ha i suoi limiti: confronta parole, non il significato. "Come calcolare una derivata" e "tasso di variazione istantaneo" sono semanticamente vicini ma non condividono parole chiave. Il passo successivo: indicizzare i chunk in embeddings (vettori di significato) e cercare per similarità coseno.
// principe : chaque chunk a un vecteur ; on cherche les plus proches de la question
$questionVec = $this->embedder->embed($question);
$nearest = $this->vectorStore->search($questionVec, topK: 4);
Ma iniziare in full-text permette di consegnare rapidamente e migliorare in seguito — la filosofia che applico su tutti i miei progetti.
Cosa ritengo
- RAG = prima recuperare, poi generare. Si ancora il LLM ai SUOI dati.
- Il full-text MySQL basta per un primo RAG utile, senza database vettoriale.
- L'istruzione "unicamente a partire dal contesto" riduce fortemente le allucinazioni.
- Suddividere il contenuto in chunk ben dimensionati è determinante per la qualità.
- Gli embeddings vengono dopo, quando si fa sentire l'esigenza di ricerca semantica.